

Problem: Görsel regresyon neden sürekli bakım istiyor
Görsel regresyon paketin kırmızı yanıyor ve kimse neden kırıldığına bakmıyor; ekip “approve all” basıp devam ediyor. Bu noktaya geldiyse paket artık test değil, bir onay ritüeli. Üstelik bu tipik bir son: piksel karşılaştırmaya dayalı görsel regresyon, olgunlaştıkça değer üretmeyi bırakıp bakım üretmeye başlar.
Üç kronik sorun var. Birincisi baseline şişmesi: her viewport, her tema, her dil için ayrı referans görüntü tutarsın, repo yüzlerce PNG taşır ve kimse hangi görüntünün neyi koruduğunu hatırlamaz. İkincisi yanlış pozitifler: anti-aliasing, farklı GPU’da font hinting, işletim sistemi emoji seti, scrollbar genişliği — hiçbiri ürün hatası değildir ama hepsi diff üretir. Üçüncüsü toplu onay: tasarımcı buton radius’unu 4px’ten 8px’e çekince 180 baseline birden kırılır ve bunların arasına gerçek bir regresyon karışırsa kimse fark etmez. Toplu onayın asıl bedeli budur — gürültünün içinde saklanan tek gerçek bulgu.
Piksel karşılaştırma gerçekte neyi doğruluyor
Piksel diff bir eşitlik kontrolüdür, bir yargı değil. “Bu ekran doğru görünüyor mu?” sorusunu cevaplamaz; “bu ekran dünden farklı mı?” sorusunu cevaplar. Bu ikisi aynı şey değil ve aradaki fark, görsel regresyonun neden sürekli bakım istediğini de açıklar.
Fark tespiti referansa ihtiyaç duyar, kriter bilmez. Kabul kriteri doğrulaması ise kritere ihtiyaç duyar, referans bilmez. Baseline’ın içinde zaten bozuk bir hizalama varsa piksel diff onu sonsuza kadar “doğru” sayar; çünkü ölçtüğü şey doğruluk değil, değişmezlik. Aynı şekilde “hata mesajı kullanıcıya görünüyor mu” sorusu piksel karşılaştırmanın cevaplayabileceği bir soru değildir — o mesaj dünden beri eksikse diff yeşil yanar. UI testlerinin otomatikleştirilmesi tartışmasının düğüm noktası tam burası.
Ekran görüntüsü analiz eden agent ne yapar
Multimodal bir model ekran görüntüsünü girdi olarak alır ve doğal dilde yazılmış bir beklentiye göre yargı üretir: “form alanları dikey eksende hizalı mı”, “hata mesajı ilgili alanın altında görünür mü”, “kesilmiş veya üç noktaya düşmüş metin var mı”, “boş durum ekranı yerine ham JSON görünüyor mu”. Çıktı sadece boolean değil, gerekçeli bir değerlendirmedir: hangi kriter, neden geçmedi, ekranın neresinde.
Buradaki asıl değişim şu: baseline gerekmez, kriter gerekir. Referans görüntü tutmayı bırakıp, ekranın sağlaması gereken koşulları yazmaya başlarsın. Kriterler koda girer, versiyonlanır, code review’dan geçer. Tasarım değiştiğinde 180 PNG’yi onaylamazsın; değişen kriteri düzeltirsin — ya da çoğu zaman hiçbir şey yapmazsın, çünkü “alanlar hizalı olmalı” kuralı radius değişince bozulmaz. Yapay zeka destekli test otomasyonunun test tarafında somut karşılığı olan birkaç yerden biri bu.
Microsoft Agent Framework ile çalışan bir doğrulama akışı
Kritik olan nokta: agent serbest metin döndürürse assertion yazamazsın. “Ekran genel olarak iyi görünüyor ancak…” cümlesinden bir test sonucu çıkmaz. Bu yüzden çıktıyı şemayla zorlamak zorunludur.
# visual_agent.py
import base64
from pydantic import BaseModel, Field
from agent_framework import ChatMessage, DataContent, Role, TextContent
from agent_framework.openai import OpenAIChatClient


class Bulgu(BaseModel):
    kriter: str = Field(description="Değerlendirilen kriterin aynen kendisi")
    gecti: bool
    gerekce: str = Field(description="Ekranda görülen kanıta dayalı tek cümle")
    konum: str = Field(description="Bulgunun ekrandaki yeri, yoksa 'yok'")


class Degerlendirme(BaseModel):
    tum_kriterler_gecti: bool
    bulgular: list[Bulgu]


TALIMAT = """Sen bir UI doğrulama uzmanısın. Sana bir ekran görüntüsü ve
kriter listesi verilir. Her kriteri TEK TEK, yalnızca görüntüde gördüğün
kanıta dayanarak değerlendir.

Kurallar:
- Görüntüde olmayan bir şey hakkında tahmin yürütme; göremiyorsan kriteri
  geçmemiş say ve gerekçede 'görüntüde kanıt yok' yaz.
- Estetik yorum yapma. Sadece verilen kriterlere cevap ver.
- Her kriter için tam bir bulgu üret; kriter sayısı ile bulgu sayısı eşit olsun.
"""

_client = OpenAIChatClient(model_id="gpt-4o")
_agent = _client.create_agent(
    name="ui-degerlendirici",
    instructions=TALIMAT,
    temperature=0.0,
)


async def degerlendir(png: bytes, kriterler: list[str]) -> Degerlendirme:
    b64 = base64.b64encode(png).decode("ascii")
    mesaj = ChatMessage(
        role=Role.USER,
        contents=[
            TextContent(
                text="Kriterler:\n" + "\n".join(f"- {k}" for k in kriterler)
            ),
            DataContent(uri=f"data:image/png;base64,{b64}", media_type="image/png"),
        ],
    )
    cevap = await _agent.run(mesaj, response_format=Degerlendirme)
    return cevap.value
Testten kullanımı:
# test_odeme_ekrani.py
import pytest
from playwright.async_api import async_playwright

from visual_agent import degerlendir

KRITERLER = [
    "Kart numarası alanının altında kırmızı bir hata mesajı görünüyor.",
    "Form alanlarının sol kenarları aynı dikey hizada.",
    "Hiçbir metin kutusunun dışına taşmıyor veya kesilmiş değil.",
    "Ekranda İngilizce metin yok; tüm metinler Türkçe.",
    "Ödeme butonu hata durumunda da tıklanabilir görünümde.",
]


@pytest.mark.asyncio
async def test_odeme_formu_hata_durumu():
    async with async_playwright() as p:
        tarayici = await p.chromium.launch()
        sayfa = await tarayici.new_page(viewport={"width": 1280, "height": 800})
        await sayfa.goto("https://example.com/odeme")
        await sayfa.get_by_label("Kart numarası").fill("4111")
        await sayfa.get_by_role("button", name="Ödemeyi tamamla").click()
        await sayfa.get_by_text("Kart numarası geçersiz").wait_for()
        png = await sayfa.screenshot()
        await tarayici.close()

    sonuc = await degerlendir(png, KRITERLER)
    basarisiz = [b for b in sonuc.bulgular if not b.gecti]
    assert not basarisiz, "\n".join(
        f"[{b.kriter}] {b.gerekce} ({b.konum})" for b in basarisiz
    )
Dikkat edilecek iki ayrıntı: ekran görüntüsü alınmadan önce beklenen elemanın wait_for ile beklenmesi (yarı yüklenmiş ekran, agent’ın da piksel diff’in de düşmanı) ve assertion mesajının gerekçeyi taşıması. Testin neden kırıldığını CI logundan okuyamıyorsan, agent’ın ürettiği gerekçe boşa gider.
Akışın mimarisi: nerede deterministik, nerede olasılıksal
Agent’ı test hattına sokarken tek kural var: olasılıksal katmanı mümkün olduğu kadar küçük tut. Navigasyon, etkileşim, ekran görüntüsü yakalama, eşik hesabı ve raporlama deterministik kalır. Yalnızca “bu görüntü bu kriteri sağlıyor mu” sorusu modele gider.
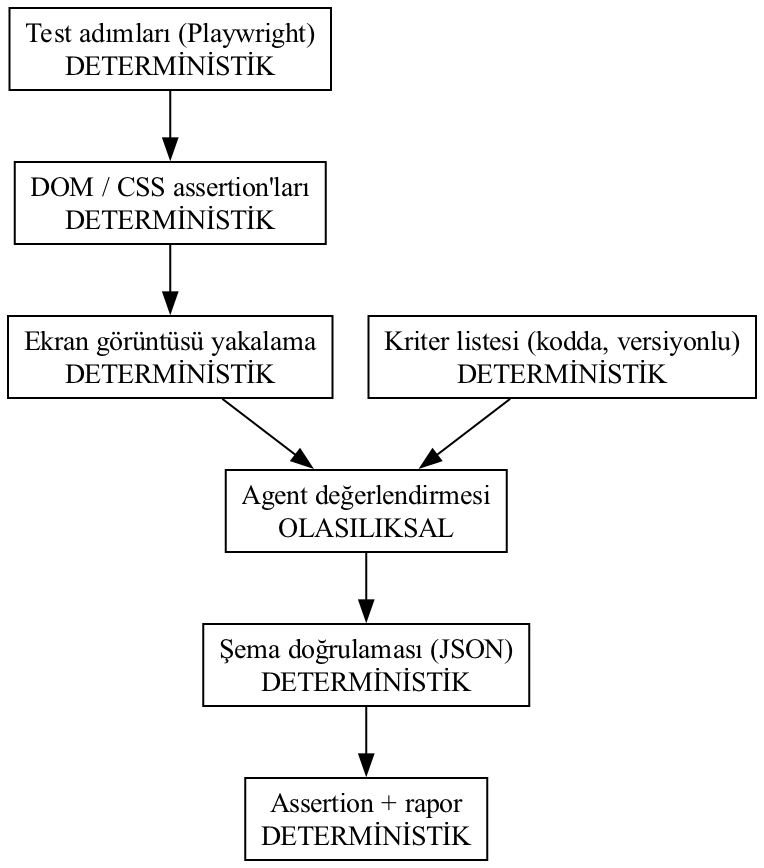
Şema doğrulaması sınırın bekçisidir: modelin çıktısı Pydantic’ten geçemiyorsa test altyapı hatasıyla düşer, “belirsiz” diye yeşile boyanmaz.
Kararlılık: aynı ekran görüntüsü, iki farklı cevap
Agent tabanlı doğrulamanın asıl riski kalite değil, kararlılık. Aynı girdiye farklı çıktı üreten bir assertion, flaky testin ders kitabı tanımıdır — ve flaky testin kök nedenini bulmak burada bir kat daha zor, çünkü kararsızlık uygulamada değil değerlendiricide.
Tipik olarak kararsızlık belirli kriterlerde yoğunlaşır: öznel ifadeler (“ekran düzgün görünüyor mu”, “tasarım tutarlı mı”), ölçü isteyen ifadeler (“boşluklar yeterli mi”) ve birden fazla şeyi tek cümlede soran bileşik kriterler. Dar, tek olguya bakan ve gözle doğrulanabilir kriterler (“şu metin görünür durumda mı”, “şu metin kesilmiş mi”) belirgin biçimde daha kararlı davranır.
Azaltma yolları, etkili olandan başlayarak: sıcaklığı sıfıra çek; kriteri tek olguya indir ve “ve/veya” içeren kriterleri böl; çıktıyı şemayla zorla ve her bulguda gerekçe iste — gerekçe zorunluluğu modeli kanıta bağlar; ikili/kritik kriterlerde N kez çağırıp çoğunluk al; aynı görüntü hash’i için sonucu önbelleğe al, böylece tekrar koşan testte cevap sabit kalsın. Hiçbiri sorunu bitirmez. Bu yüzden agent’ın verdiği “geçmedi” kararını doğrudan deploy’u durduran bir kapı yapmak yerine, önce raporlayan bir katman olarak koşturmak daha sağlıklı.
Maliyet ve süre: 400 ekran görüntüsünü her PR’da analiz etmek
Piksel diff milisaniyeler sürer ve marjinal maliyeti sıfırdır; model çağrısı saniyeler sürer ve her görüntü için token ücreti çıkarır. Dört yüz ekranı her PR’da modele göndermek, hem hat süresini hem faturayı test paketinin en pahalı kalemine çevirir. Test otomasyonunda performans optimizasyonu mantığı burada da aynı: pahalı adımı az sayıda yere koy.
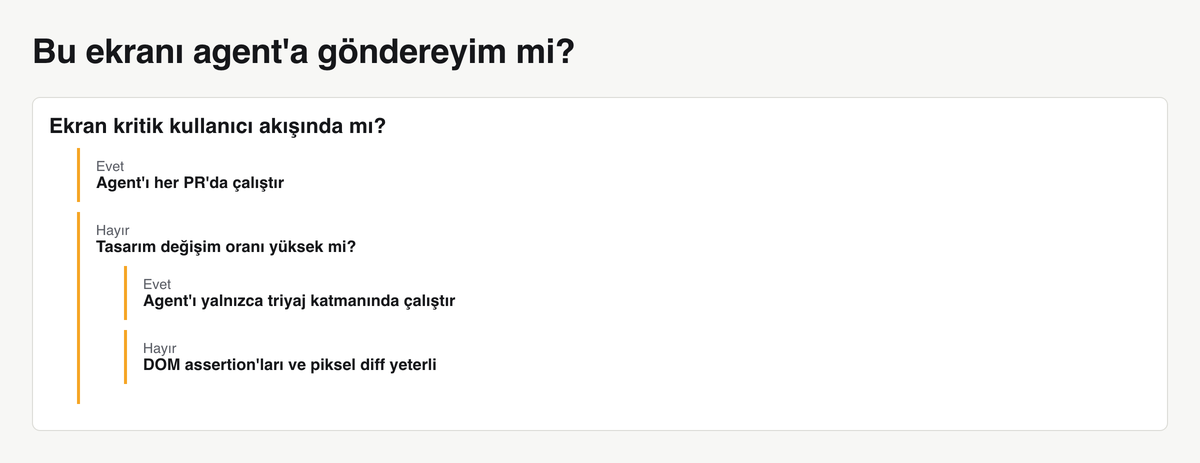
Seçim kuralı somut olmalı. Agent’ı şu üç gruba uygula:
- Kritik kullanıcı akışları: kayıt, giriş, ödeme, sipariş onayı. Burada bozuk bir ekran doğrudan gelir kaybı.
- Tasarım değişim oranı yüksek sayfalar: son aylarda sık dokunulan ekranlar. Baseline’ın en çok kırıldığı yer, insan gözünün en çok yorulduğu yerdir.
- Erişilebilirlik hassas bileşenler: kontrast, odak göstergesi, hata mesajı görünürlüğü — DOM’dan okunamayan, piksel diff’in umursamadığı şeyler.
Geri kalan her şey DOM assertion’ları ve piksel diff ile kalsın.
Hangisi hangi işte: karşılaştırma tablosu
| Piksel karşılaştırma | DOM/CSS assertion | Agent değerlendirmesi | |
|---|---|---|---|
| Tespit türü | Dünden farkı bulur | Tanımlı kuralı doğrular | Kriteri yargılar |
| Bakım yükü | Yüksek: baseline onayı | Orta: seçici kırılganlığı | Düşük: kriter metni |
| Yanlış pozitif | Render gürültüsü | Seçici değişimi | Kararsız yargı |
| Maliyet | Milisaniye, sıfır ücret | Milisaniye, sıfır ücret | Saniye, token ücreti |
| CI uygunluğu | Her koşuda | Her koşuda | Seçili akışlarda |
Tabloyu okuma biçimi şu: agent diğer ikisinin yerine geçmiyor, ikisinin de cevaplayamadığı soruyu cevaplıyor. Piksel diff “değişti mi”, DOM assertion “doğru elemanlar doğru değerlerle var mı”, agent “kullanıcı bu ekranda ne görüyor” sorusuna bakıyor.
Agent’ın kaçırdıkları ve yakaladıkları
Yakaladıkları, insanın gözüne ilk çarpan hatalar: kesilen veya üç noktaya düşen metin, üst üste binen elemanlar, boş durum ekranı yerine görünen ham hata metni, çevirinin düşmemesi yüzünden ekranda kalan İngilizce etiketler, arka planla kaynaşmış düşük kontrastlı yazı, yüklenmemiş görsellerin kırık ikon olarak durması, modal arkasında kalan ve okunamayan içerik.
Kaçırdıkları, ölçüm isteyen hatalar: 2 piksellik kayma, marka renginin bir ton sapması, font-weight 500’den 600’e geçmesi, 16px yerine 14px satır yüksekliği. Bu farklar insan gözünün de kaçırdığı farklardır; onları yakalayan şey piksel diff’tir ve bu yüzden piksel diff hâlâ hattan çıkmaz. Hangi aracı nereye koyacağını bu iki liste belirler: ölçülebilir fark → diff, anlamlı fark → agent.
Kademeli bir strateji: ikisini birlikte kurmak
En iyi kurulum agent’ı doğrulayıcı değil triyajcı yapar. Sıra şu: önce ucuz ve deterministik katman (DOM assertion’ları), sonra piksel diff, yalnızca diff kırmızı yandığında agent’a “bu fark kullanıcı için anlamlı mı” diye sor. Böylece model çağrısı yalnızca gerçekten fark olan yerlerde çalışır ve “approve all” refleksi yerini sınıflandırılmış bir listeye bırakır.
# triyaj.py
import base64
from pathlib import Path

from agent_framework import ChatMessage, DataContent, Role, TextContent
from agent_framework.openai import OpenAIChatClient
from PIL import Image, ImageChops
from pydantic import BaseModel, Field


class Triyaj(BaseModel):
    kategori: str = Field(
        description="render-gurultusu | kasitli-tasarim | regresyon"
    )
    kullaniciya_etkisi: bool
    gerekce: str


TALIMAT = """Sana aynı ekranın iki hâli verilir: önce referans, sonra güncel
görüntü. Aralarında piksel farkı tespit edildi. Görevin bu farkı
sınıflandırmak.

- render-gurultusu: anti-aliasing, font yumuşatma, 1-2 piksellik kayma gibi
  kullanıcının fark edemeyeceği farklar.
- kasitli-tasarim: renk, köşe yarıçapı, boşluk, ikon gibi tutarlı biçimde
  uygulanmış tasarım güncellemeleri.
- regresyon: kesilen metin, üst üste binen eleman, kaybolan buton, boş alan,
  okunamayan kontrast gibi kullanıcıyı engelleyen farklar.

Emin değilsen 'regresyon' de ve gerekçede belirsizliği yaz."""

_agent = OpenAIChatClient(model_id="gpt-4o").create_agent(
    name="gorsel-triyaj", instructions=TALIMAT, temperature=0.0
)


def piksel_fark_orani(referans: Path, guncel: Path) -> float:
    a = Image.open(referans).convert("RGB")
    b = Image.open(guncel).convert("RGB")
    if a.size != b.size:
        return 1.0
    diff = ImageChops.difference(a, b).convert("L")
    farkli = sum(1 for px in diff.getdata() if px > 12)
    return farkli / (a.width * a.height)


def _icerik(png: Path) -> DataContent:
    b64 = base64.b64encode(png.read_bytes()).decode("ascii")
    return DataContent(uri=f"data:image/png;base64,{b64}", media_type="image/png")


async def farki_siniflandir(referans: Path, guncel: Path) -> Triyaj:
    mesaj = ChatMessage(
        role=Role.USER,
        contents=[
            TextContent(text="Referans görüntü:"),
            _icerik(referans),
            TextContent(text="Güncel görüntü:"),
            _icerik(guncel),
        ],
    )
    cevap = await _agent.run(mesaj, response_format=Triyaj)
    return cevap.value


async def gorsel_kapi(referans: Path, guncel: Path, esik: float = 0.0015) -> None:
    oran = piksel_fark_orani(referans, guncel)
    if oran <= esik:
        return
    sonuc = await farki_siniflandir(referans, guncel)
    if sonuc.kategori == "render-gurultusu" and not sonuc.kullaniciya_etkisi:
        print(f"[bilgi] fark %{oran * 100:.3f}, gürültü sayıldı: {sonuc.gerekce}")
        return
    raise AssertionError(
        f"Görsel fark %{oran * 100:.3f} — {sonuc.kategori}: {sonuc.gerekce}"
    )
Buradaki kazanç iki katmanlı. Gürültü otomatik eleniyor, yani kırmızıların sayısı düşüyor. Kalan kırmızılar ise “kasitli-tasarim” ve “regresyon” diye ayrılmış geliyor; baseline’ı onaylamadan önce okunacak tek satır bir gerekçeyle. Bu, toplu onay refleksini kıran şeydir — çünkü artık onaylanacak 180 görüntü değil, okunacak 180 etiketli karar var ve içlerindeki tek regresyon görünür durumda. Test verisinin her koşuda aynı ekranı üretmesi de bu kurulumun ön şartı; değişken veri doğrudan görsel gürültüye dönüşür, bkz. test verisi yönetimi.
Bunu kendi projende denemek için ilk üç adım
Bir akış seç. Tüm paketi dönüştürmeye kalkma. Ödeme ya da kayıt gibi tek bir kritik akışta, 5-10 ekranda başla.
Mevcut durumu ölç. Son 30 günün görsel regresyon kırılmalarını say ve her birini üç kovaya ayır: render gürültüsü, kasıtlı tasarım değişikliği, gerçek bug. Gerçek bug oranın düşükse — ki toplu onay alışkanlığı olan ekiplerde tipik olarak düşüktür — paketin şu anda bakım maliyetinden başka bir şey üretmiyor demektir. Bu sayı, agent’ı eklemenin değer üretip üretmediğini ölçeceğin tek taban çizgisi.
Agent’ı önce triyaj katmanına koy. Doğrudan doğrulayıcı yapma; diff kırmızı yandığında sınıflandıran katman olarak koştur ve iki hafta sonra aynı üç kovayı tekrar say. Yanlış pozitif oranı düşmediyse kriterlerini daralt ya da geri al. Ölçmeden karar verme; “AI ekledik” cümlesi bir kalite göstergesi değil.